知识工作的产出是报告、意见书和投资结论,其中大部分工作却发生在写作之前:判断哪些材料相关,哪项条款适用,哪个数字与管理层的说法不符。注意力投向哪里、结论建立在什么之上,都由这些判断决定。
专业判断有两个特点。其一,许多判断依赖对情境的识别和专业的直觉,并不需要冗长的推理;有经验的律师读到一项条款,往往很快就知道它是否构成限制。其二,判断的数量远多于结论;一个投资结论背后,是对大量文件、主体和时间点的逐一筛选。
近年来提升模型能力的主要路径是扩大参数、延长推理,即 scaling System 2。它抬高了单次判断的上限,也抬高了单次判断的成本,覆盖面因此受预算直接约束。本文讨论另一条路径:在单次判断足够可靠的前提下,把判断的成本降低一到两个数量级,从而扩展判断的数量与覆盖面。我们称之为 scaling System 1。
我们以 Jev 为案例。Jev 是一个以选择、评分和概率形式输出判断的模型。1 下面用法律和金融领域的公开数据依次回答三个问题:不依赖长推理的判断能达到什么水平;成本降低之后,同样的预算能覆盖多少;长推理应当用在哪里。随后用两个案例说明这些判断如何进入实际研究。
1. 专业判断不必依赖长推理
我们在同一批题目上分别调用 Jev 和 DeepSeek V4.1 Flash 的两个档位,每题一次。下文将 DeepSeek 简写为 DS,两个档位统一记作“无思考”和“中等”。
| Benchmark | Jev 原生判别 | DS 无思考 | DS 中等 |
|---|---|---|---|
| MAUD | 77/90 | 70/90 | 79/90 |
| ContractNLI | 121/170 | 125/170 | 125/170 |
| FinDVer-KNOW | 49/60 | 38/60 | 46/60 |
| FinArgQuality | 46/96 | 50/96 | 51/96 |
| Consumer Contracts QA | 32/32 | 31/32 | 32/32 |
| 单题时延中位数 | 0.4–0.5 秒 | 1.1–1.3 秒 | 1.8–9.5 秒 |
| 五项任务整批费用合计 | $0.044 | $0.911 | $1.904 |
任务:MAUD 为并购协议中的9类法律标准判断;ContractNLI 为保密协议推断;FinDVer-KNOW 为财报结论的知识密集验证;FinArgQuality 为业绩会论证质量,24条论证×4个维度,Jev采用事先确定的分维度校准;Consumer Contracts QA 为 LegalBench 的消费者合同权利义务问答(正式任务名 consumer_contracts_qa),取32个不重复片段各1问。分数为正确数 / 判断数,不是整套数据集的规模。
设置:无思考对应 reasoning_effort=none,中等对应 reasoning_effort=medium;Jev为原生结构化判别接口,强调色仅用于标识Jev列,不表示每行最优。时延为各任务单题中位数的范围,不是整批耗时。
判断能力不必依附于大模型。 在都不使用长推理的条件下,Jev 与 DS(无思考)互有胜负,整体处于同一水平,Jev 的费用约为后者的 1/20。这提示,至少在这些任务上,判断质量更多取决于模型是否被塑造成一个判断者,即在受约束的选项之间给出可比较的分数,而不在于参数中储存了多少通用知识。
长推理的收益取决于任务结构。 开启思考后,DS 在 MAUD 和 FinDVer 上分别多答对9题和8题,在 ContractNLI 和 FinArgQuality 上几乎没有提升。前两项需要逐条对照法律标准、核对财务口径,推理步骤本身有用;后两项更依赖语义直觉与主观权衡,多想一步未必更准。即便在受益最多的 MAUD 和 FinDVer 上,Jev 也以 DS(中等)1/46 和 1/37 的费用达到了相近的成绩。FinArgQuality 按 Macro-F1 计,三者为 .376、.352 和 .423。
我们还构造了一组专业取舍测试,要求在约束、时间和成本之间作出选择。下面保留各模型实际使用的快速配置:
| 模型 | 推理设置 | 主行动匹配 |
|---|---|---|
| Jev 1.13.0 | 原生判别 | 5/9 |
| DeepSeek V4.1 Flash | 无思考 | 6/9 |
| GLM-5.3-Flash | 低 | 6/9 |
| Gemini 3.6 Flash | 无思考 | 7/9 |
| Hunyuan 3 | 无思考 | 5/9 |
| Cogito-32B | 直接回答 | 5/9 |
| Qwen3-30B-A3B | 直接回答 | 1/9 |
| BERT-MNLI | 蕴含判别 | 2/9 |
任务:作者构造的9个金融、法律和医疗情境,每题12条记录、5个候选行动。
设置:DS为 none,GLM为 low,Gemini为 thinking budget=0,Hunyuan为 no_think。BERT将候选行动转为文本蕴含判断。
各快速档位之间差距不大,明显的分界在 BERT 一行:它同样快,但只能判断文本是否蕴含,无法在多个约束之间权衡。可见快速判断的价值在于速度之外仍保留了取舍能力,这正是专业判断与文本匹配的区别。
2. 更低的成本,更大的覆盖面
我们把 FinDVer 的60道题按固定顺序交给各模型,逐题累计费用,观察正确判断数随支出的增长。
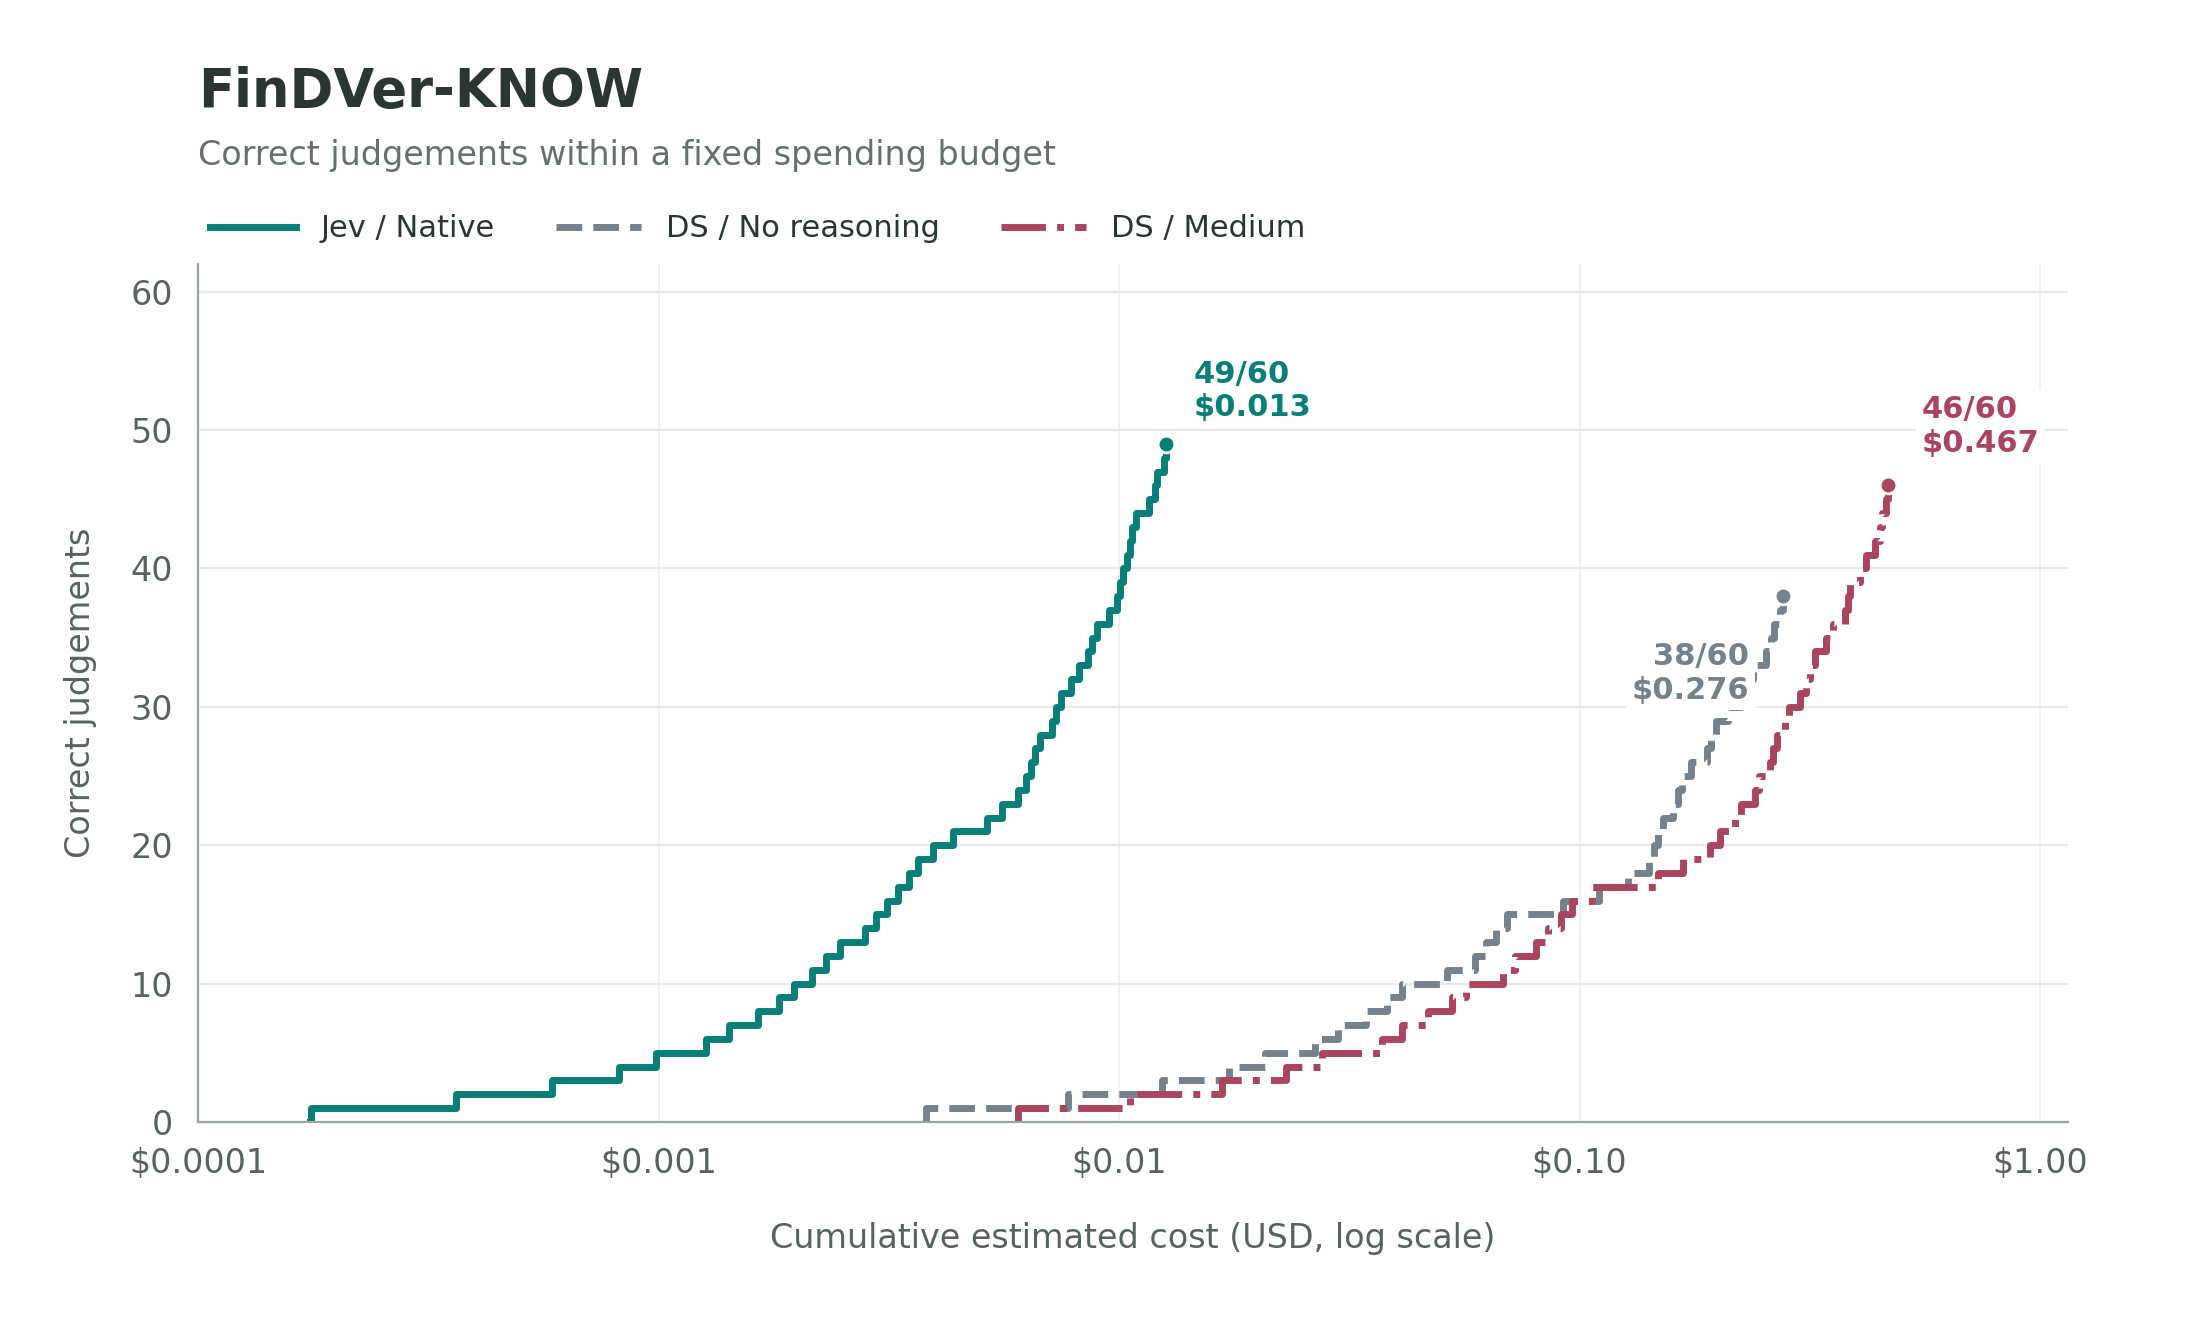
图 1 · FinDVer-KNOW,60题,固定题序。横轴为累计估算费用(对数坐标),纵轴为累计正确判断数。
三条曲线形状相近,说明单题准确率的差别有限;拉开距离的是横轴。花费 $0.01 时,Jev 已处理47题、答对38题,DS(中等)仅处理1题。
在预算约束下,更有意义的问题是同样的花费能换来多少个正确判断,单题准确率只是其中一个因子。研究中待判断的对象没有天然上限,文件、主体和时间点都可以继续增加。单次成本下降一个数量级,原本只读摘要的材料可以读原文,原本抽样检查的对象可以全量检查。这是 scaling System 1 所沿的方向。
3. 让长推理集中在低置信之处
扩展 System 1 的目的,是让 System 2 集中用在关键之处。Jev 为每个判断输出置信度。2 我们按固定配额,把置信度最低的题目交给 DS,升级名单在调用 DS 之前确定。
| Benchmark 升级设置 | 留给 Jev 题量 · 正确率 | 交给 DS 题量 · 升级前 → 后 | Jev+路由 正确数 | 全量 DS 正确数 | 估算费用 路由 / 全量 |
|---|---|---|---|---|---|
| MAUD 中等 | 67题 92.5% | 23题 65.2% → 78.3% | 80/90 | 79/90 | $0.105 / $0.306 |
| ContractNLI 无思考 | 130题 83.8% | 40题 57.5% → 70.0% | 137/170 | 125/170 | $0.147 / $0.458 |
| FinDVer-KNOW 中等 | 45题 86.7% | 15题 66.7% → 66.7% | 49/60 | 46/60 | $0.163 / $0.467 |
读表:任务定义见表 1;“留给Jev”为不升级的部分,“升级前 → 后”为同一组被选题目上的Jev → DS正确率。“全量DS”使用该行标注的同一推理档位;费用以美元计,包含全部初判及必要后续调用。
置信度的作用,是把错误集中到一个可以识别的区域。三项任务中,Jev 保留部分的正确率都明显高于交出部分,长推理因此只需覆盖约四分之一的题目。两类模型出错的位置也不尽相同:MAUD 上,Jev 答对而 DS(中等)答错的有5题,反之有7题。路由同时保留了两者的长处,三项任务的最终成绩都不低于任一单独模型。ContractNLI 的级联为完整在线运行,整批耗时25.1秒;另次补测的全量 DS(无思考)为71.9秒。
在这种分工中,System 1 决定哪里值得多想,System 2 负责把这些地方想清楚。判断越便宜、置信度越可靠,昂贵的推理就越能集中在真正困难的问题上。
4. 在研究中扩展判断:两个案例
以下两个案例展示低成本判断在研究流程中的两种用法:在一个问题之内组织证据,以及在较长时间内跟踪假设。
3M:每股收益上升,持续盈利能力是否改善?
3M 2022年报中,GAAP 每股收益从10.12升至10.18美元,调整后每股收益却从10.73降至10.10美元,经营现金流也在下降。研究问题是:每股收益的上升是否来自持续经营的改善。
我们从年报中摘出17段材料,涵盖利润、调整口径、现金流、诉讼与环境义务等,两两组合,做了136组Jev关系判断:两段材料是否应当放在一起看,是否相互限定。DS(中等)再依据这份关系清单回到原文写作报告。由于单次判断足够便宜,可以对全部材料两两比较,不必事先猜测哪些材料彼此相关。
EPS 与现金流背离 → Jev 组织证据关系 → 报告追问:盈利下降有多少来自原材料与汇率,有多少来自经营本身?
报告由此把”盈利质量走弱”推进为一个可检验的问题:如果下降主要来自暂时因素,结论可以缓和;否则应继续检查其余业务。Jev 的产出是一份值得核查的问题清单,结论仍由综合模型和研究者给出。
CVS:新披露能否让旧判断重新进入研究队列?
这个案例考察长期跟踪。研究者维护一组工作假设;每当新披露到来,由 Jev 判断它是否触及某个假设、是否需要提醒研究者复核。
2020年末,CVS 仍有约139亿美元未使用的回购授权,第四季度却没有回购,研究中据此保留”公司是否在优先保留资本”的假设。2022年报随后披露了约35亿美元的实际回购。
旧假设:保留资本? → 新证据:实际回购约35亿美元 → Jev 提醒:回购已恢复,资本配置假设值得更新。
这一提醒需要区分”授权”与”执行”,再把新披露接回旧假设。长期跟踪的工作量等于新材料数乘以在跟踪的假设数,并随时间不断累积,这个乘积很快会超出长推理的预算,却正适合低成本判断。在八个案例、每个案例96条时序更新的跟踪实验中,Jev 发出的12条提醒均有来源支持。
5. 展望:规模、能力与普惠
扩大判断的规模。 本文的实验以数十到数百道题为单位。真实的专业工作面对的是完整的文件库、持续更新的披露和多年的时间跨度。当判断覆盖到这样的规模,问题将从”每次判断是否正确”转向”整体上是否看到了该看到的东西”。
通过针对性训练增强专业判断能力。 实验表明,专业判断并不必然依赖参数规模与长推理,而可以作为一种独立的能力来构建。围绕法律标准辨析、财务口径核对、论证质量评估等具体判断类型,用专业标注和结构化的判断任务进行训练,有望在不增加单次成本的前提下继续提高判断质量,使更多问题无需升级到长推理就能可靠完成。
让专业判断成为普惠的能力。 今天,对大量文件进行持续、细致的专业审视,往往只有大型机构负担得起。当可靠的判断足够便宜,个人投资者、小型律所和独立研究者也能读得更广、跟得更久、更早发现问题。我们期待的分工是:快速判断负责铺开,长推理负责深挖,人负责最终的决定。
参考资料
- TypeSafe. Jev:模型与定价。
- TypeSafe. Confidence versus Probability。
- MAUD:并购协议理解。
- ContractNLI:合同推断。
- FinDVer:金融文档中的结论验证。
- FinArgQuality:业绩会论证质量。